深色模式
L9 层感知容器调度仿真
目标
- 把一篇组内论文的系统模型写成可以运行的仿真器。论文是 LDLS:Layer Dependency-aware Learning Scheduling Algorithms for Containers in Mobile Edge Computing(IEEE TMC 2023);
- 实现 6 种基线调度算法,看清“只看负载”和“只看层共享”各自的问题;
- 用策略梯度(REINFORCE)训练一个调度策略,和基线比较;
- 学会用多个随机种子做实验、画训练曲线、做敏感性分析。
做完以后,你会明白组内调度类论文的实验是怎么做出来的,手里也有了一个可以继续扩展的实验框架。
| 难度 | 对应方向 | 需要 GPU | 预计用时 |
|---|---|---|---|
| 中等 | 四 | 否,笔记本电脑的 CPU 就够 | 1~2 天 |
开始之前:读读组内论文中关于 LDLS 的部分(符号表、任务的时间线、MDP 三要素),以及强化学习中 MDP 和策略梯度的部分。本实验用最简单的策略梯度算法 REINFORCE,PPO 可以做完以后再学。
背景:为什么要“层感知”
Docker 镜像由多层组成,例如 python:3.12-slim 和 python:3.13-slim 都建立在同一个 Debian 基础层上(见 Docker 的镜像层)。节点上已经有的层不需要再下载。边缘节点带宽小,一个几百 MB 的镜像要下载几十秒到几分钟,远比任务本身的计算时间长,所以把任务调度到已经有它所需层的节点上,能大幅缩短完成时间。
但只看层共享也不行:任务会集中到少数“层最全”的节点上,排队越来越长。好的调度要在层共享和负载均衡之间取得平衡,这正是 LDLS 用强化学习、LRScheduler 用动态权重要解决的问题。
交互演示:层感知调度
动手之前,先在下面体会一下层共享和负载均衡之间的权衡:4 个节点、几种共享基础层的镜像,自己决定每个任务放到哪个节点,再和几种策略比一比。
环境
bash
mkdir container-sim && cd container-sim
uv venv
uv pip install numpy matplotlib
uv pip install torch --index-url https://download.pytorch.org/whl/cpu   # 只用 CPU,安装包小很多
已经装好 GPU 版 PyTorch 的环境也可以直接用。下面的命令都用 uv run python 运行,也可以先激活虚拟环境再用 python。
第 1 步:准备镜像层数据
仿真需要一组镜像,以及每个镜像由哪些层组成、每层多大。有两种方式,格式相同,可以随时切换。
方式一:合成数据(推荐先用)
模仿真实镜像的共享结构:少数基础系统层被很多镜像共享,运行时层(Python、Node、JDK 等)被一部分镜像共享,应用层基本不共享。
python
# make_images.py:生成一组合成镜像,层的共享关系模仿真实镜像(基础系统层 → 运行时层 → 应用层)
import json
import random

rng = random.Random(0)


def layer(prefix, size_mb):
    return {"digest": f"{prefix}-{rng.randrange(16**8):08x}", "size_mb": round(size_mb, 1)}


bases = [layer("base", rng.uniform(30, 120)) for _ in range(4)]           # 如 debian、ubuntu、alpine
runtimes = []                                                              # 如 python、node、jdk、cuda
for _ in range(10):
    base = rng.choice(bases)
    runtimes.append([base] + [layer("rt", rng.uniform(50, 400)) for _ in range(rng.randint(1, 3))])

images = []
for i in range(60):
    stack = rng.choice(runtimes)
    app = [layer("app", rng.uniform(1, 300)) for _ in range(rng.randint(1, 3))]  # 应用层基本不共享
    images.append({"name": f"img{i:02d}", "layers": stack + app})

json.dump(images, open("images.json", "w"), indent=1)
sizes = [sum(l["size_mb"] for l in im["layers"]) for im in images]
print(f"{len(images)} 个镜像,平均 {sum(sizes) / len(sizes):.0f} MB,最大 {max(sizes):.0f} MB")
bash
uv run python make_images.py
# 60 个镜像,平均 868 MB,最大 1536 MB
方式二:从 Docker Hub 读取真实镜像的层
Docker 镜像仓库提供了读取镜像清单(manifest)的接口,清单里列出了每一层的摘要(digest)和大小。下面的脚本只读取清单,不下载镜像本身:
python
# fetch_layers.py:从 Docker Hub 读取镜像的层信息(只读清单,不下载镜像本身)
import json
import sys
import time
import urllib.request

ACCEPT = ", ".join([
    "application/vnd.oci.image.index.v1+json",
    "application/vnd.docker.distribution.manifest.list.v2+json",
    "application/vnd.oci.image.manifest.v1+json",
    "application/vnd.docker.distribution.manifest.v2+json",
])


def get_json(url, token=None, accept=None):
    req = urllib.request.Request(url)
    if token:
        req.add_header("Authorization", f"Bearer {token}")
    if accept:
        req.add_header("Accept", accept)
    with urllib.request.urlopen(req, timeout=30) as resp:
        return json.load(resp)


def image_layers(image):
    """image 形如 python:3.12-slim 或 bitnami/redis:7.4,返回 linux/amd64 版本的层列表"""
    name, _, tag = image.partition(":")
    tag = tag or "latest"
    repo = name if "/" in name else f"library/{name}"
    token = get_json(
        f"https://auth.docker.io/token?service=registry.docker.io&scope=repository:{repo}:pull"
    )["token"]
    base = f"https://registry-1.docker.io/v2/{repo}/manifests/"
    manifest = get_json(base + tag, token, ACCEPT)
    if "manifests" in manifest:  # 多架构镜像:先找到 linux/amd64 对应的清单
        digest = next(
            m["digest"] for m in manifest["manifests"]
            if m.get("platform", {}).get("os") == "linux"
            and m.get("platform", {}).get("architecture") == "amd64"
        )
        manifest = get_json(base + digest, token, ACCEPT)
    return [{"digest": l["digest"], "size_mb": round(l["size"] / 2**20, 2)} for l in manifest["layers"]]


if __name__ == "__main__":
    images = [line.strip() for line in open(sys.argv[1]) if line.strip() and not line.startswith("#")]
    out = []
    for image in images:
        try:
            layers = image_layers(image)
        except Exception as e:  # 网络问题、镜像不存在、触发频率限制等
            print(f"跳过 {image}:{e}")
            continue
        out.append({"name": image, "layers": layers})
        print(f"{image}: {len(layers)} 层,共 {sum(l['size_mb'] for l in layers):.0f} MB")
        time.sleep(1)  # 放慢速度,避免触发 Docker Hub 的频率限制
    json.dump(out, open("images.json", "w"), indent=1)
    print(f"已保存 {len(out)} 个镜像到 images.json")
把要读取的镜像写进 images.txt,每行一个:
text
python:3.12-slim
python:3.12
node:22-slim
redis:7.4
mysql:8.4
nginx:latest
wordpress:latest
tomcat:latest
bash
uv run python fetch_layers.py images.txt
# python:3.12-slim: 4 层,共 41 MB
# python:3.12: 7 层,共 393 MB
# ……
注意:
- 清单中的大小是压缩后的大小,也就是实际要下载的量。
- Docker Hub 对未登录的请求有频率限制,具体次数以 Docker 官方文档为准。一次读几十个镜像没有问题,不要写循环大量抓取。
- 国内网络可能连不上 Docker Hub,这时先用合成数据,或者参考国内网络加速。
- LDLS 用的是同样思路收集的数据:70 个镜像、378 个层。
第 2 步:仿真器
sim.py 把论文的系统模型翻译成代码。先看对应关系:
| 论文中 | 代码中 |
|---|---|
节点 n 的带宽 b_n、CPU 频率 f_n、存储 d_n、最多同时运行的容器数 C_n | Node 的 bandwidth、freq、storage、slots |
任务 k 的到达时刻、请求的容器 c_k、计算量 p_k | Task 的 arrival、image、cycles |
层 l 在节点 n 上的下载完成时刻 z_ln(t) | Node.layers 字典 |
| 下载时间(式 1):所需层中最晚的下载完成时刻减去当前时刻,每个节点同一时刻只下载一层 | estimate() 中的下载部分,download_free 是下载队列空闲的时刻 |
计算时间(式 2):p_k / f_n | estimate() 中的 compute |
| 存储约束(式 5) | mask() 排除放不下镜像的节点;存储不够时按 LRU 删除不用的层 |
| 参数设置:存储 5~15 GB、带宽 60~90 Mbps、CPU 0.8~1.2 GHz、10 个节点 | reset() |
python
# sim.py:层感知容器调度的仿真环境。系统模型参考 LDLS(IEEE TMC 2023)第 3 节,做了简化
import json
import random
from dataclasses import dataclass, field

import numpy as np


@dataclass
class Node:
    bandwidth: float                              # 下载带宽 b_n,MB/s
    freq: float                                   # CPU 频率 f_n,GHz
    storage: float                                # 存储空间 d_n,MB
    slots: list                                   # 每个容器槽位空闲的时刻,槽位数即 C_n
    layers: dict = field(default_factory=dict)    # 本地的层:digest -> 下载完成时刻 z_ln
    in_use: dict = field(default_factory=dict)    # digest -> 最后一个使用它的任务结束的时刻
    download_free: float = 0.0                    # 下载队列空闲的时刻(同一时刻只下载一层)


@dataclass
class Task:
    arrival: float   # 到达时刻 t,秒
    image: int       # 请求的镜像 c_k
    cycles: float    # 计算量 p_k,G cycles


def load_images(path):
    return json.load(open(path))


class ClusterEnv:
    n_features = 6

    def __init__(self, images, n_nodes=10, n_tasks=500, arrival_rate=0.3, slots=4):
        self.images = images
        self.size = {l["digest"]: l["size_mb"] for im in images for l in im["layers"]}
        self.image_mb = [sum(l["size_mb"] for l in im["layers"]) for im in images]
        self.n_nodes, self.n_tasks, self.rate, self.n_slots = n_nodes, n_tasks, arrival_rate, slots

    def reset(self, seed):
        rng = random.Random(seed)
        self.nodes = [
            Node(bandwidth=rng.uniform(60, 90) / 8,      # 60~90 Mbps 换算成 MB/s
                 freq=rng.uniform(0.8, 1.2),             # 0.8~1.2 GHz
                 storage=rng.uniform(5, 15) * 1024,      # 5~15 GB
                 slots=[0.0] * self.n_slots)
            for _ in range(self.n_nodes)
        ]
        # 镜像热度服从 Zipf 分布:少数镜像被频繁请求。任务按泊松过程到达
        order = list(range(len(self.images)))
        rng.shuffle(order)
        weights = [1 / (r + 1) for r in range(len(order))]
        t, self.tasks = 0.0, []
        for _ in range(self.n_tasks):
            t += rng.expovariate(self.rate)
            self.tasks.append(Task(t, rng.choices(order, weights)[0], rng.uniform(20, 80)))
        self.k = 0
        self.completion = []    # 每个任务的完成时间 T_k
        return self.tasks[0]

    def estimate(self, n, task):
        """把 task 放到节点 n 的各项时间:下载(式 1)、计算(式 2)、等空闲槽位"""
        node, now = self.nodes[n], task.arrival
        t_free = max(now, node.download_free)
        done, missing = now, 0.0
        for l in self.images[task.image]["layers"]:
            if l["digest"] in node.layers:        # 已有或正在下载:等它下完
                done = max(done, node.layers[l["digest"]])
            else:                                 # 没有:排进下载队列
                missing += l["size_mb"]
                t_free += l["size_mb"] / node.bandwidth
                done = max(done, t_free)
        compute = task.cycles / node.freq
        start = max(done, min(node.slots))
        return {"missing_mb": missing, "download": done - now, "wait": start - done,
                "compute": compute, "total": start + compute - now}

    def mask(self, task):
        """可行的节点:存储空间放得下这个镜像"""
        return np.array([self.image_mb[task.image] <= nd.storage for nd in self.nodes])

    def observe(self, task):
        """状态:每个节点一行特征,大致缩放到 0~1 附近"""
        rows = []
        for n, node in enumerate(self.nodes):
            e = self.estimate(n, task)
            used = sum(self.size[d] for d in node.layers)
            rows.append([e["missing_mb"] / 1000, e["download"] / 100, e["wait"] / 100,
                         e["compute"] / 100, e["total"] / 100, 1 - used / node.storage])
        return np.array(rows, dtype=np.float32)

    def _make_room(self, node, need, missing, now):
        """存储不够时,按最近最少使用(LRU)删除当前没有任务在用的层"""
        free = node.storage - sum(self.size[d] for d in node.layers)
        victims = sorted((d for d in node.layers
                          if d not in need and node.layers[d] <= now and node.in_use.get(d, 0) <= now),
                         key=lambda d: node.in_use.get(d, 0))
        for d in victims:
            if free >= missing:
                break
            free += self.size[d]
            del node.layers[d]
            node.in_use.pop(d, None)

    def step(self, n):
        """执行动作:把当前任务调度到节点 n。返回 (下一个任务, 奖励, 是否结束)"""
        task, node = self.tasks[self.k], self.nodes[n]
        e = self.estimate(n, task)
        layers = self.images[task.image]["layers"]
        self._make_room(node, {l["digest"] for l in layers}, e["missing_mb"], task.arrival)
        t_free = max(task.arrival, node.download_free)
        for l in layers:
            if l["digest"] not in node.layers:
                t_free += l["size_mb"] / node.bandwidth
                node.layers[l["digest"]] = t_free
        if e["missing_mb"] > 0:
            node.download_free = t_free
        i = int(np.argmin(node.slots))
        finish = task.arrival + e["total"]
        node.slots[i] = finish
        for l in layers:
            node.in_use[l["digest"]] = max(node.in_use.get(l["digest"], 0), finish)
        self.completion.append(e["total"])
        self.k += 1
        done = self.k == self.n_tasks
        return (None if done else self.tasks[self.k]), -e["total"] / 100, done


# ---------------- 基线算法:输入环境和当前任务,返回节点编号 ----------------

def _pick(scores, mask, rng):
    """在可行节点中选分数最高的,分数相同随机选一个"""
    scores = np.where(mask, scores, -np.inf)
    best = np.flatnonzero(scores == scores.max())
    return int(rng.choice(best))


def random_policy(env, task, rng):
    return _pick(np.zeros(env.n_nodes), env.mask(task), rng)


def least_loaded(env, task, rng):
    """选正在运行的容器最少的节点,不看镜像"""
    busy = [sum(s > task.arrival for s in nd.slots) for nd in env.nodes]
    return _pick(-np.array(busy), env.mask(task), rng)


def kube_image(env, task, rng):
    """镜像粒度(类似 K8s 默认的 ImageLocality):完整镜像已在本地的节点加分,再看空闲程度"""
    layers = [l["digest"] for l in env.images[task.image]["layers"]]
    scores = []
    for nd in env.nodes:
        has_image = all(d in nd.layers for d in layers)
        idle = sum(s <= task.arrival for s in nd.slots) / len(nd.slots)
        scores.append(0.5 * has_image + 0.5 * idle)
    return _pick(np.array(scores), env.mask(task), rng)


def dep_layer(env, task, rng):
    """层粒度(类似 Dep):本地已有的层越多(按大小算)分数越高,相同时选空闲的"""
    layers = env.images[task.image]["layers"]
    scores = [sum(l["size_mb"] for l in layers if l["digest"] in nd.layers) - 1e-3 * min(nd.slots)
              for nd in env.nodes]
    return _pick(np.array(scores), env.mask(task), rng)


def lrs_like(env, task, rng):
    """动态权重(思路类似 LRScheduler):节点空闲时看重层共享,繁忙时看重负载均衡"""
    layers = env.images[task.image]["layers"]
    scores = []
    for nd in env.nodes:
        shared = sum(l["size_mb"] for l in layers if l["digest"] in nd.layers) / env.image_mb[task.image]
        idle = sum(s <= task.arrival for s in nd.slots) / len(nd.slots)
        w = 0.7 if idle >= 0.5 else 0.2
        scores.append(w * shared + (1 - w) * idle)
    return _pick(np.array(scores), env.mask(task), rng)


def greedy_estimate(env, task, rng):
    """短视贪心:估计每个节点上的完成时间,选最小的。只看眼前这一个任务"""
    return _pick(-np.array([env.estimate(n, task)["total"] for n in range(env.n_nodes)]), env.mask(task), rng)


BASELINES = {"Random": random_policy, "LeastLoaded": least_loaded, "Kube": kube_image,
             "Dep": dep_layer, "LRS": lrs_like, "Greedy": greedy_estimate}


def run_baseline(env, policy, seed):
    task, rng, done = env.reset(seed), random.Random(seed), False
    while not done:
        task, _, done = env.step(policy(env, task, rng))
    return float(np.mean(env.completion))


if __name__ == "__main__":
    import argparse

    p = argparse.ArgumentParser()
    p.add_argument("--images", default="images.json")
    p.add_argument("--nodes", type=int, default=10)
    p.add_argument("--rate", type=float, default=0.3)
    args = p.parse_args()
    env = ClusterEnv(load_images(args.images), n_nodes=args.nodes, arrival_rate=args.rate)
    for name, policy in BASELINES.items():
        res = [run_baseline(env, policy, seed) for seed in range(5)]
        print(f"{name:12s} 平均完成时间 {np.mean(res):7.1f} s(5 次的标准差 {np.std(res):.1f})")
和论文相比做了几处简化,复现论文时要逐一补上:
- 没有云节点。LDLS 中有一个算力不受限、但每次都要下载全部层的云节点。
- 等待空闲槽位的时间单独计算,容器只在计算期间占用槽位。
- 存储不够时按最近最少使用(LRU)删除层,而论文把存储作为约束条件。
- 和论文一样,忽略任务数据从用户传到节点的时间。
运行基线:
bash
uv run python sim.py我们在合成数据上得到的结果(你的数字可能略有不同):
text
Random       平均完成时间   243.2 s(5 次的标准差 35.2)
LeastLoaded  平均完成时间   163.4 s(5 次的标准差 23.2)
Kube         平均完成时间    69.8 s(5 次的标准差 5.0)
Dep          平均完成时间   551.2 s(5 次的标准差 173.2)
LRS          平均完成时间    75.1 s(5 次的标准差 6.6)
Greedy 平均完成时间 60.2 s(5 次的标准差 3.4)先停下来想一想,再往下读:
- Dep 为什么最差,甚至比随机还差? 它只看层共享:哪个节点的层最全就选哪个,结果任务都挤到同一个节点上,排队越来越长。这就是 LRScheduler 要加入动态权重的原因。
- LeastLoaded 为什么也不好? 它只看负载,把任务分散到各个节点,每个节点都要重新下载各种镜像。下载时间远大于计算时间时,这样做很吃亏。
- Greedy 为什么最好? 它直接估计每个节点上的完成时间(下载、等待、计算都算上),选最小的。它的缺点是只看眼前这一个任务,不考虑这次决策对以后任务的影响。
第 3 步:用策略梯度训练调度策略
把调度写成马尔可夫决策过程:
| 要素 | 本实验 | LDLS |
|---|---|---|
| 状态 | 每个节点 6 个特征:需要下载的数据量、估计的下载时间、等待时间、计算时间、完成时间、剩余存储比例 | 各节点的层分布矩阵(每层是否已有、剩余下载时间、层大小)、资源状态(CPU 频率、带宽、剩余下载时间),加上把当前任务放到各节点的估计值(需下载的层数、下载时间、等待时间、计算时间)和任务信息(论文 4.1 节) |
| 动作 | 选一个节点 | 选一个边缘节点或云 |
| 奖励 | 当前任务完成时间的相反数(除以 100 缩放) | 当前任务完成时间的相反数 |
| 回合 | 500 个任务 | 2000 个任务 |
| 训练算法 | REINFORCE(最简单的策略梯度) | PPO(带 clip 目标),状态先经过因子分解机(FM)嵌入提取层之间的依赖 |
策略网络对每个节点打一个分,再用 softmax 变成选择各个节点的概率。所有节点共用同一个小网络,所以训练好的策略可以直接用在节点数不同的集群上。
python
# pg.py:用策略梯度(REINFORCE)训练调度策略,并与基线比较
import argparse
import csv
import random

import numpy as np
import torch
import torch.nn as nn

from sim import BASELINES, ClusterEnv, load_images, run_baseline


class Scorer(nn.Module):
    """给每个节点打一个分。所有节点共用同一个小网络,所以节点数变了也能直接用"""

    def __init__(self, dim):
        super().__init__()
        self.net = nn.Sequential(nn.Linear(dim, 64), nn.ReLU(), nn.Linear(64, 64), nn.ReLU(), nn.Linear(64, 1))

    def forward(self, x):            # x: [节点数, 特征数] -> [节点数]
        return self.net(x).squeeze(-1)


def run_policy(env, policy, seed, sample=True):
    """跑完一个回合。sample=True 时按概率采样动作(训练),否则选概率最大的动作(测试)"""
    task, done = env.reset(seed), False
    logps, rewards = [], []
    while not done:
        x = torch.from_numpy(env.observe(task))
        mask = torch.from_numpy(env.mask(task))
        logits = policy(x).masked_fill(~mask, -1e9)   # 动作掩码:不可行的节点概率为 0
        dist = torch.distributions.Categorical(logits=logits)
        a = dist.sample() if sample else logits.argmax()
        logps.append(dist.log_prob(a))
        task, r, done = env.step(int(a))
        rewards.append(r)
    return logps, rewards


def main():
    p = argparse.ArgumentParser()
    p.add_argument("--images", default="images.json")
    p.add_argument("--nodes", type=int, default=10)
    p.add_argument("--rate", type=float, default=0.3)
    p.add_argument("--episodes", type=int, default=300)
    p.add_argument("--gamma", type=float, default=0.95)
    p.add_argument("--lr", type=float, default=1e-3)
    p.add_argument("--seed", type=int, default=0)
    args = p.parse_args()

    random.seed(args.seed)
    np.random.seed(args.seed)
    torch.manual_seed(args.seed)
    env = ClusterEnv(load_images(args.images), n_nodes=args.nodes, arrival_rate=args.rate)
    policy = Scorer(env.n_features)
    opt = torch.optim.Adam(policy.parameters(), lr=args.lr)

    log = open(f"train_seed{args.seed}.csv", "w", newline="")
    writer = csv.writer(log)
    writer.writerow(["episode", "mean_completion_s"])
    for ep in range(args.episodes):
        # 训练用的种子(1000 以后)和测试用的种子(0~4)分开,避免在测试集上训练
        logps, rewards = run_policy(env, policy, seed=1000 + ep)
        returns, g = [], 0.0
        for r in reversed(rewards):           # 折扣回报 G_t = r_t + γ G_{t+1}
            g = r + args.gamma * g
            returns.append(g)
        returns = torch.tensor(returns[::-1])
        adv = (returns - returns.mean()) / (returns.std() + 1e-8)   # 标准化,减小方差
        loss = -(torch.stack(logps) * adv).mean()
        opt.zero_grad()
        loss.backward()
        opt.step()
        writer.writerow([ep, float(np.mean(env.completion))])
        if ep % 20 == 0:
            print(f"回合 {ep:4d}  训练回合平均完成时间 {np.mean(env.completion):7.1f} s")
    log.close()
    torch.save(policy.state_dict(), f"policy_seed{args.seed}.pt")

    print("\n在测试种子 0~4 上比较:")
    results = {name: [run_baseline(env, fn, s) for s in range(5)] for name, fn in BASELINES.items()}
    results["PG"] = []
    with torch.no_grad():
        for s in range(5):
            run_policy(env, policy, s, sample=False)
            results["PG"].append(float(np.mean(env.completion)))
    for name, res in results.items():
        print(f"{name:12s} {np.mean(res):7.1f} ± {np.std(res):5.1f} s")


if __name__ == "__main__":
    main()
几个要点:
- 动作掩码:不可行节点的分数设为一个很小的数,被选中的概率几乎为 0。论文中“改进的动作选择”是类似的思路。
- 折扣回报:一个调度决策不只影响当前任务,还会影响后面的任务(例如占用了下载队列)。
gamma越大,越看重长期影响。 - 标准化:回报减去均值、除以标准差,能明显降低策略梯度的方差,训练更稳定。
- 训练和测试分开:训练用种子 1000 以后生成的任务序列,测试用种子 0~4,和基线在同样的任务序列上比较。
用 3 个随机种子训练:
bash
for s in 0 1 2; do uv run python pg.py --seed $s; done每次训练 300 个回合,在笔记本电脑的 CPU 上约需 1~2 分钟。我们的结果中,PG 在 3 个种子上的测试结果分别为 66.4、70.5、74.7 秒:
text
在测试种子 0~4 上比较:
Random         243.2 ±  35.2 s
LeastLoaded    163.4 ±  23.2 s
Kube            69.8 ±   5.0 s
Dep            551.2 ± 173.2 s
LRS             75.1 ±   6.6 s
Greedy          60.2 ±   3.4 s
PG              66.4 ±   3.6 s
画训练曲线:
python
# plot.py:画训练曲线(多个随机种子的均值和范围)
import glob

import matplotlib.pyplot as plt
import numpy as np

plt.rcParams.update({"font.size": 12, "pdf.fonttype": 42})
curves = [np.loadtxt(f, delimiter=",", skiprows=1)[:, 1] for f in sorted(glob.glob("train_seed*.csv"))]
n = min(len(c) for c in curves)
data = np.array([c[:n] for c in curves])
# 每个回合的结果波动很大,先做滑动平均再画
k = 10
smooth = np.array([np.convolve(c, np.ones(k) / k, mode="valid") for c in data])
x = np.arange(smooth.shape[1]) + k - 1

fig, ax = plt.subplots(figsize=(4.5, 3))
ax.plot(x, smooth.mean(axis=0), label=f"PG ({len(curves)} seeds)")
ax.fill_between(x, smooth.min(axis=0), smooth.max(axis=0), alpha=0.25)
ax.set_xlabel("Episode")
ax.set_ylabel("Mean completion time (s)")
ax.grid(alpha=0.3)
ax.legend()
fig.tight_layout()
fig.savefig("train_curve.pdf")
fig.savefig("train_curve.png", dpi=150)
print("已保存 train_curve.pdf")
bash
uv run python plot.py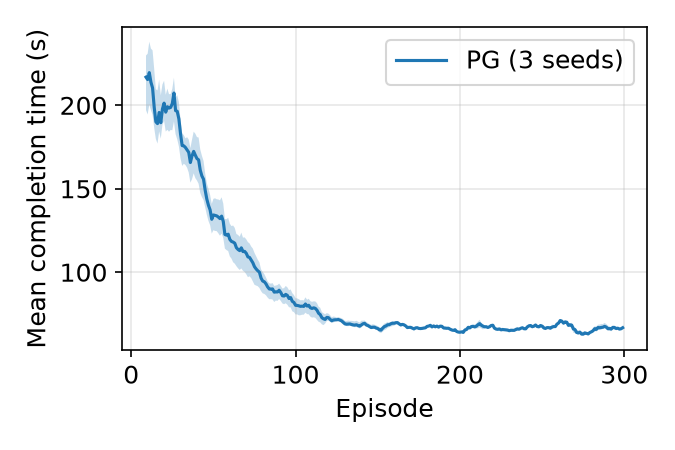
平均完成时间在前 120 个回合左右从 200 多秒降到 70 秒左右,之后基本稳定。
PG 没有超过 Greedy,正常吗?
正常,而且这是本实验最值得思考的地方:
- 状态里已经包含了 Greedy 用的“估计完成时间”,所以 PG 学到的策略很接近 Greedy。要超过它,必须利用 Greedy 看不到的长期影响,比如把热门镜像的层集中放在带宽大的节点上,或者避免堵塞某个节点的下载队列。
- 本实验的负载不高,长期影响不明显。把到达率调高(
--rate 0.5),我们得到 Greedy 78.4 秒、PG 81.7 秒,两者接近,其他基线都在 129 秒以上。 - REINFORCE 是最简单的策略梯度算法,方差大。3 个种子的结果相差 8 秒,就是方差大的体现。论文里的强化学习方法在特征提取、动作选择和训练算法上都做了改进,例如 LDLS 用 FM 嵌入提取层依赖,用 PPO 训练。
这也说明:写论文时一定要和强的启发式算法比较。只和随机调度比,什么方法都显得很好。
第 4 步:敏感性分析
改变一个参数,看各算法的表现怎么变化。例如改变节点数:
bash
for n in 5 10 20; do echo "== $n 个节点"; uv run python sim.py --nodes $n; done我们的结果中,节点少时差距被放大:5 个节点时 Greedy 为 121.0 秒,Kube 为 255.0 秒,LRS 为 213.1 秒;20 个节点时三者分别为 56.8、64.1、64.5 秒。
再测试在 10 个节点上训练的策略能否直接用在 20 个节点上:
python
# gen_test.py
import numpy as np
import torch

from pg import Scorer, run_policy
from sim import ClusterEnv, load_images

env = ClusterEnv(load_images("images.json"), n_nodes=20)
policy = Scorer(env.n_features)
policy.load_state_dict(torch.load("policy_seed1.pt"))
res = []
with torch.no_grad():
    for s in range(5):
        run_policy(env, policy, s, sample=False)
        res.append(np.mean(env.completion))
print(f"10 个节点上训练的策略,在 20 个节点上测试:{np.mean(res):.1f} s")
bash
uv run python gen_test.py
# 10 个节点上训练的策略,在 20 个节点上测试:63.6 s
结果和 20 个节点时的 LRS 相当,比 Greedy 差一些。共享打分网络让策略不需要重新训练就能用在不同规模的集群上。
预期结果
- 6 种基线和 PG 的对比表(均值 ± 标准差)
- 3 个种子的训练曲线
- 至少一组敏感性分析(节点数、到达率或带宽)
延伸练习
- 加入云节点:算力不受限,但每次都要下载全部层。观察负载高时有多少任务被调度到云上。
- 换成真实镜像数据:用
fetch_layers.py读取 30~50 个常用镜像,比较和合成数据的结果有什么不同。真实镜像之间共享的层多吗? - 换训练算法:参考 CleanRL 的单文件实现,改用带价值网络的 Actor-Critic 或 PPO,看方差能否降低。
- 先模仿再强化:先让策略模仿 Greedy 的选择(监督学习),再用策略梯度微调。这和 VELO 用专家示范加速训练是一个思路。
- 加特征:例如每个层在近期任务中的热度、节点下载队列的长度,看 PG 能否超过 Greedy。
- 用真实负载:用阿里巴巴集群 trace 生成任务的到达时间和计算量。
- 改进 LRS:现在的阈值和权重是随手设的,试着调整它们,或者让权重随负载连续变化。
- 参加挑战赛:把你改进后的策略提交到调度算法挑战赛(即将开放),在隐藏的测试数据上和其他同学比一比。
- 写成 Gymnasium 环境:按 Gymnasium 的接口包装
ClusterEnv,就能直接使用现成的强化学习库。
常见问题
fetch_layers.py报 429 Too Many Requests:触发了 Docker Hub 的频率限制,过一段时间再试,或者先用合成数据。fetch_layers.py连接超时:网络无法访问 Docker Hub,先用合成数据。- 训练曲线不下降:先确认基线的结果合理(仿真器没问题);再试着调小学习率,或者检查奖励的缩放是否合适。
- 每次运行结果不同:强化学习本来就有随机性。固定种子能让同一个种子的结果可以重复,比较算法时要看多个种子的均值和波动。
记录要求
除了实验总览中的通用要求,还要回答:
- Dep 和 LeastLoaded 各自的问题是什么?用你的数据说明。
- PG 和 Greedy 的差距在哪些条件下变大、在哪些条件下变小?
- 你的仿真器和 LDLS 的系统模型还有哪些不同?如果要复现 LDLS 的实验,还需要补充什么?